Supercomputação e clusters HPC
Semanas de cálculo em horas de máquina.
Clusters de alto desempenho projetados para a carga de trabalho real do seu grupo de pesquisa, não para um catálogo.
Supercomputação e clusters HPC
Clusters de alto desempenho projetados para a carga de trabalho real do seu grupo de pesquisa, não para um catálogo.
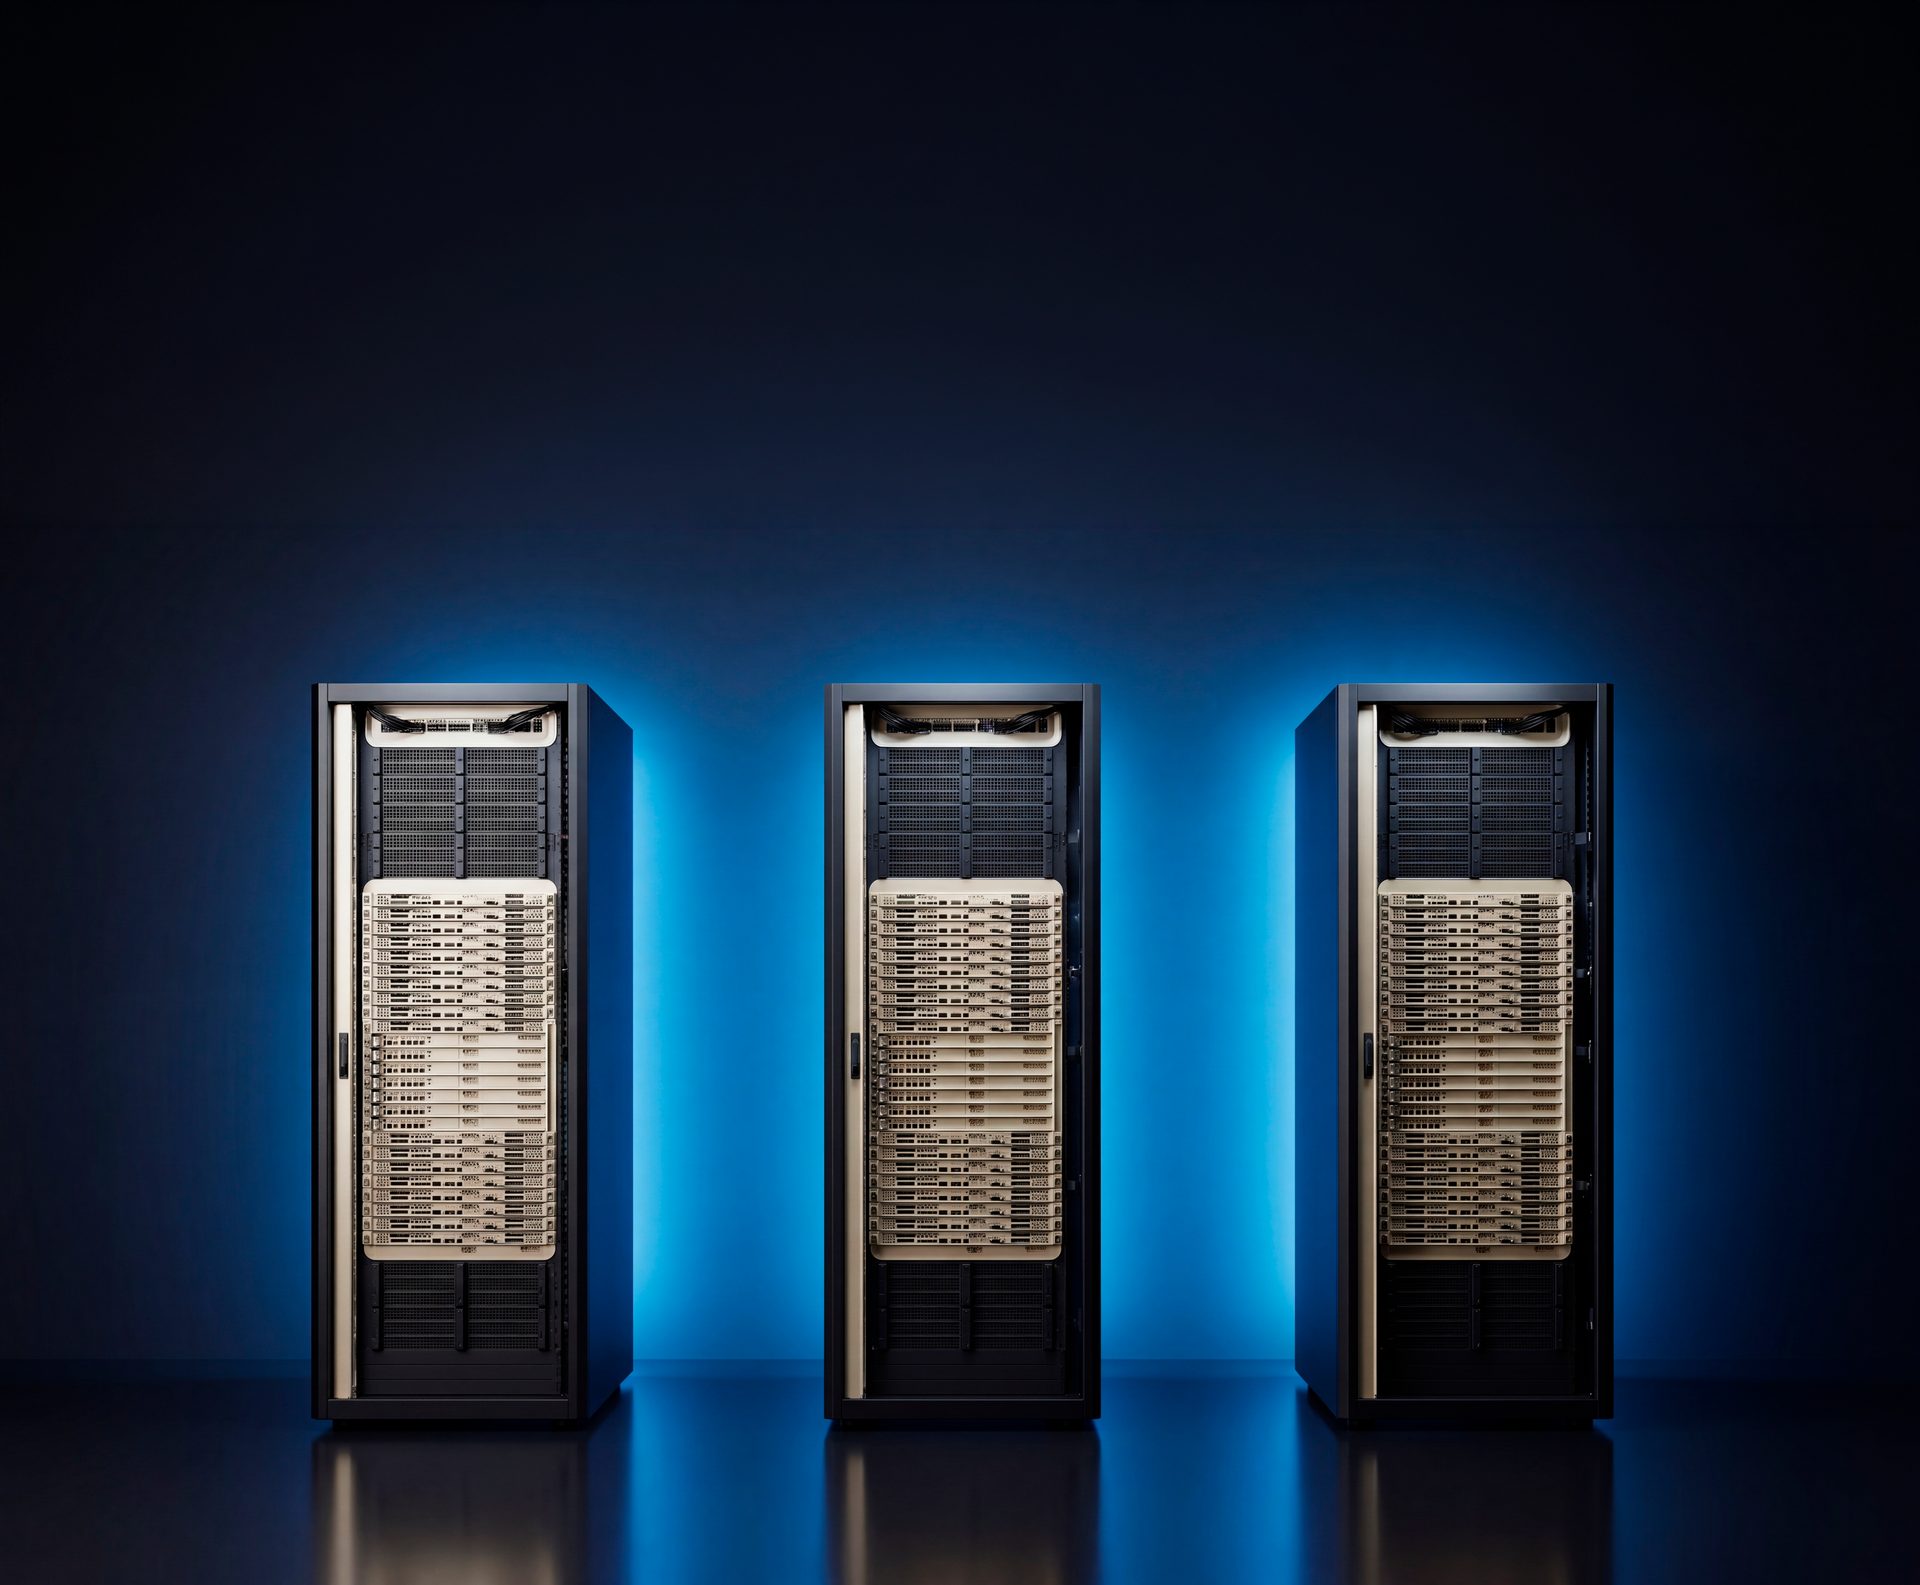
Nós de computação e de GPU, storage paralelo, rede de baixa latência, refrigeração e energia, sobre arquiteturas AIVRES e KAYTUS com aceleração NVIDIA.
Sistema operacional, provisionamento dos nós, rede, autenticação, escalonador de filas, políticas de uso compartilhado e as aplicações científicas do grupo.
Cotas por grupo, filas por prioridade e treinamento de administradores e usuários finais, para que dezenas de pesquisadores dividam a mesma máquina.
Em cluster de GPU, boa parte do tempo é gasto movendo dado entre nós. Por isso a camada de rede entra no projeto junto com a de cálculo: InfiniBand com computação dentro da própria rede para os ambientes mais sensíveis a latência, Ethernet de alta velocidade para ambientes multiusuário.
O que costuma rodar
Refrigeração do cluster
A escolha não é de preferência, é de física. Ela depende de quanta energia cada rack consome e de quanto calor a sala consegue remover.
Ventilação e contenção de corredor. Atende bem racks de densidade convencional, até a faixa de 15 kW, e é o que a maior parte das salas já tem instalado. Para muitos clusters de pesquisa, continua sendo a resposta certa.
Placa fria em contato com o processador, solução híbrida ou rack totalmente líquido. Sustenta densidades que o ar não alcança e é requisito nas plataformas de GPU mais recentes.